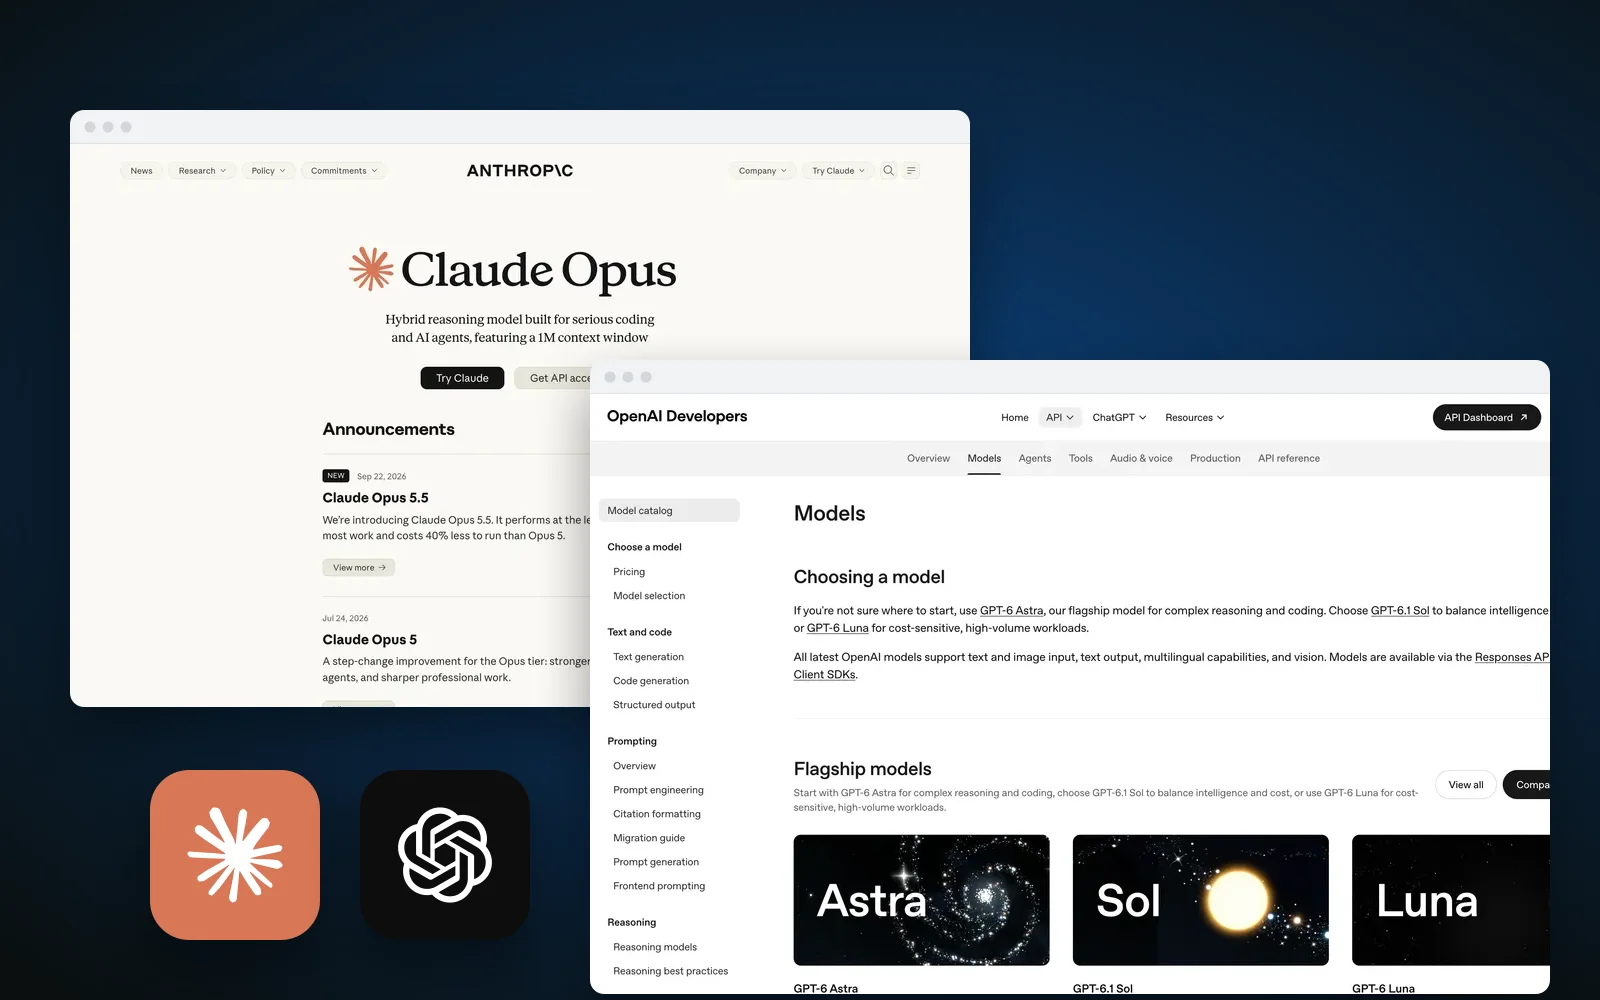
Claude Opus 5.5 vs GPT-6.1 Sol.
Claude Opus 5.5 tiene más nota, 59 frente a 55, pero GPT-6.1 Sol es casi 8 veces más barato por tarea.
Anthropic y OpenAI
Datos del 13 de noviembre de 2026.
¿Cuál es mejor?
Claude Opus 5.5 tiene más nota en el índice de inteligencia de Artificial Analysis, 59 frente a 55. Es el 3.º de los 58 modelos que puntúa, y GPT-6.1 Sol, el 5.º.
En las cuatro pruebas de programar y razonar, Claude Opus 5.5 gana FrontierCode 2.0, Terminal-Bench 4.0 y HLE Diamond, y GPT-6.1 Sol gana CritPt v2.
Por tarea, GPT-6.1 Sol es casi 8 veces más barato, 1,27 $ frente a 10,04 $, y tardan casi lo mismo, 23,3 minutos y 25,2 minutos.
Por token, Anthropic cobra 4 $ por millón de entrada y 20 $ por millón de salida, y OpenAI, 2 $ y 10 $. Leen casi lo mismo de una vez, 1 millón y 1,05 millones de tokens.
Elige Claude Opus 5.5 si
- quieres la nota más alta, 59 frente a 55
- lo quieres para programar, gana FrontierCode 2.0 y Terminal-Bench 4.0
- lo quieres para preguntas de nivel experto, saca 67,9 % frente a 58,8 % en HLE Diamond
Elige GPT-6.1 Sol si
- te importa lo que cuesta cada tarea, 1,27 $ frente a 10,04 $
De un vistazo
La nota, el coste y el tiempo por tarea y las pruebas, de Artificial Analysis, leídos el 13 de noviembre de 2026 con cada modelo a su esfuerzo más alto. El precio, el contexto y la fecha de salida, de las páginas de Anthropic y OpenAI. La tabla de los 58.
Sus pruebas
Sigue leyendo.
- Qué modelo de IA usar para crear el software de tu empresa
 IA · 13 nov 2026
- Caso de estudio de Fundaia, nuestra plataforma para publicar aplicaciones desde GitHub
 Caso de estudio · 12 nov 2026
- Caso de estudio de Alquilia, un CRM con IA que cualifica inquilinos por WhatsApp
 Caso de estudio · 12 nov 2026
- Caso de estudio de Natnatura, una tienda Shopify de complementos en España y Portugal
 Caso de estudio · 11 nov 2026
- Caso de estudio de Noura Eclat, una tienda Shopify de cosmética profesional en inglés, árabe y español
 Caso de estudio · 11 nov 2026
- Claude Code arregla despliegues fallidos, y decide una persona
 IA · 26 oct 2026
- Caso de estudio de Leaderbrock, la app interna de un equipo comercial para la agenda, los gastos y la ruta
 Caso de estudio · 10 nov 2026
- Caso de estudio de ReservPark, una app para aparcar en la calle y en garajes por horas
 Caso de estudio · 10 nov 2026
- Caso de estudio de Almacén-Pro, la herramienta con la que las tiendas comprueban la mercancía escaneando
 Caso de estudio · 11 nov 2026
- Cómo evitar las dobles reservas
 Software · 25 oct 2026
- Caso de estudio de Boathous, un marketplace de alquiler de barcos con web, apps e IA
 Caso de estudio · 10 nov 2026
Preguntas.
¿Cuál es más barato?
Por tarea, GPT-6.1 Sol, con 1,27 $ frente a 10,04 $ en las tareas del índice de Artificial Analysis. Por token, GPT-6.1 Sol, con 2 $ y 10 $ por millón de entrada y de salida frente a 4 $ y 20 $.
¿Cuál lee más texto de una vez?
Leen casi lo mismo de una vez, 1 millón y 1,05 millones de tokens.
¿Se pueden usar en servidores propios?
No. Los pesos de los dos no se publican, así que se usan a través de Anthropic y OpenAI o de quien los ofrezca.
¿Cuál usar para el software de tu empresa?
Depende del trabajo. Lo contamos en «Qué modelo de IA usar para crear el software de tu empresa».